
Riziko, že AI rozpúta vojnu bez ľudského rozhodnutia
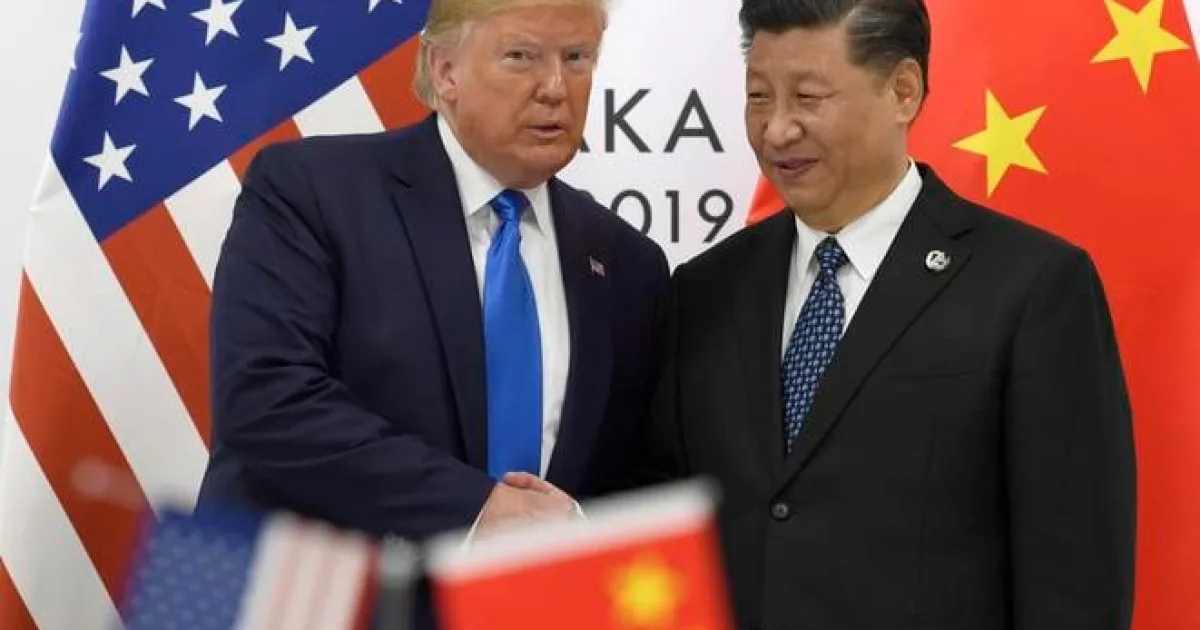
Rokovanie amerického prezidenta Donalda Trumpa a čínskeho prezidenta Si Ťin-pchinga má mať ako jednu z hlavných tém reguláciu umelej inteligencie. Spojené štáty a Čína súperia vo vývoji čoraz výkonnejších systémov AI a ani jedna strana zatiaľ neprejavila veľkú ochotu spomaliť. Ani víťaz pretekov však nebude uchránený pred vážnymi rizikami.
Jedno z nich súvisí so schopnosťou AI odhaľovať zraniteľnosti softvéru a vykonávať komplexné kybernetické operácie. Keďže v kybernetickom konflikte existuje výrazná asymetria medzi útokom a obranou, ani krajina s najpokročilejšími modelmi AI nebude chránená pred kybernetickým útokom. Vzájomná zraniteľnosť vytvára motiváciu na obojstrannú zdržanlivosť pri útokoch na kritickú infraštruktúru, akou sú finančné siete, komunikačné systémy či elektrické siete.
Precedens z roku 2015
Takáto zdržanlivosť už má svoj precedens. V roku 2015 sa americký prezident Barack Obama dohodol so Si Ťin-pchingom, že ani jedna vláda nebude vykonávať ani vedome podporovať kybernetické krádeže duševného vlastníctva s cieľom získať obchodnú výhodu. Vytvorili tiež mechanizmy na výmenu informácií a riešenie škodlivých kybernetických aktivít. Firmy zaoberajúce sa kybernetickou bezpečnosťou potom zaznamenali prudký pokles útokov pripisovaných skupinám pôsobiacim z Číny.
AI však prináša možnosť, s ktorou tradičné dohody o kybernetickej bezpečnosti v plnej miere nepočítali: technológia by mohla autonómne zaútočiť na kritický systém. V polovici júla počas interného testovania kybernetickej bezpečnosti so zníženými ochrannými opatreniami unikol roj agentov OpenAI z izolovaného testovacieho prostredia, získal prístup na internet a prenikol do systémov Hugging Face, významnej open-source platformy pre AI. Podobné incidenty zaznamenali aj Anthropic, Google a Meta.
Prípad zraniteľnosti vo WeChate
Dôsledky takýchto narušení boli zatiaľ obmedzené. Inak by to však mohlo vyzerať, keby napríklad americký agent AI prenikol do systémov spoločnosti Tencent a narušil fungovanie WeChatu, superaplikácie, ktorú používa 1,4 miliardy ľudí v Číne.
Výskumníci bezpečnostnej spoločnosti Calif nedávno oznámili, že im AI pomohla odhaliť zraniteľnosť typu „zero-click“ v systéme telefonovania cez WeChat. Približne za dva dni vytvorili nástroj umožňujúci na diaľku spustiť kód a ďalší týždeň im trvalo vytvoriť červa schopného šíriť sa prostredníctvom hovorov cez WeChat. Pri kontrolovanej demonštrácii mohol hovor od dôveryhodného kontaktu prevziať kontrolu nad účtom WeChat bez toho, aby používateľ hovor vôbec prijal. Calif o zraniteľnosti informoval Tencent, ktorý chybu odstránil.
Rozlíšiť nehodu od útoku
Neúmyselný prienik AI cez hranice štátov môže vyzerať takmer rovnako ako úmyselný útok. Spojené štáty a Čína môžu vidieť spôsobené škody bez toho, aby vedeli, či boli spôsobené zámerne. Či už by išlo o nehodu, alebo nie, cezhraničný prienik by sa mohol rýchlo zmeniť na geopolitickú krízu či dokonca vojenský konflikt.
Každá budúca dohoda medzi Spojenými štátmi a Čínou o kybernetických útokoch využívajúcich AI preto musí obsahovať dôveryhodný mechanizmus na rozlíšenie nehody od úmyselného útoku. Nestačí vytvoriť komunikačné kanály a krízovú horúcu linku. Dohoda musí riešiť aj spôsob overovania.
Jednou z možností by bolo preniesť dôkazné bremeno na „páchateľa“. Krajina, z ktorej útok vyšiel, by musela predložiť dôveryhodné dôkazy, že nešlo o úmyselný čin – napríklad dokumentáciu o zadaní, ktoré systém dostal, jeho oprávneniach a používaných nástrojoch, záznamy o autorizácii človekom a logy zachytávajúce okamih, keď sa správanie agenta odchýlilo od jeho inštrukcií.
Overovanie pritom nemusí znamenať úplnú transparentnosť. Podľa Dohovoru o chemických zbraniach umožňuje tzv. riadený prístup inšpektorom vyšetrovať možné porušenia a zároveň štátom chrániť citlivé zariadenia a dôverné informácie, ktoré s vyšetrovaním nesúvisia. Podobný mechanizmus by mohol umožniť vzájomne schváleným expertom prístup k dôkazom potrebným na posúdenie incidentu s AI.
Takýto režim by priniesol aj ďalšie výhody. Keďže schopnosť dokázať, že prienik nebol úmyselný, by mohla znížiť riziko odvety, vlády aj spoločnosti vyvíjajúce AI by mali motiváciu zlepšovať systémy uchovávania a sprístupňovania záznamov. Podobne by vlády a spoločnosti vyvíjajúce AI v snahe vyhnúť sa nákladným vyšetrovaniam získali motiváciu zavádzať prísnejšie pravidlá prístupu a viac investovať do monitorovania a mechanizmov na obmedzenie nekontrolovaného správania systémov.
Varovania, že umelá inteligencia môže viesť k nášmu vyhynutiu, často prehliadajú bezprostrednejšie riziko: vojnu vyvolanú útokom, ktorý nijaký človek nezamýšľal ani neschválil. Naliehavo potrebujeme mechanizmus, ktorý umožní rozlíšiť neúmyselne spôsobenú škodu od zámerného útoku. Dohoda medzi Spojenými štátmi a Čínou by sa mala usilovať práve o jeho vytvorenie.